Юридическая фирма хочет внутреннего ИИ-ассистента, который анализирует договоры клиентов. Медицинская клиника — систему, помогающую обрабатывать записи пациентов. Финансовая компания — модель для анализа отчётности. У всех трёх один и тот же стоп-фактор: отправлять эти данные во внешний облачный API попросту нельзя — по закону, по контракту с клиентами или из соображений элементарной коммерческой тайны. Единственный вариант получить возможности современного ИИ без утечки данных наружу — развернуть языковую модель на собственном оборудовании.
Почему открытые модели изменили расчёт «своё железо против облака»
Ещё недавно доступ к действительно мощному ИИ означал обязательный вызов внешнего API крупного провайдера. Ситуация изменилась с появлением сильных открытых моделей семейств Llama, Mistral, Qwen и подобных — по качеству ответов на многих бизнес-задачах они вплотную приближаются к закрытым коммерческим системам, и при этом полностью запускаются на собственном оборудовании компании, без единого запроса за пределы её сети.
Главный ограничитель — не ядра процессора, а видеопамять
Ключевая техническая деталь, которую стоит понимать до того, как считать бюджет: для языковых моделей решающим ресурсом является не тактовая частота процессора, а объём видеопамяти (VRAM). Веса модели должны целиком поместиться в память видеокарты — или в суммарную память нескольких видеокарт, объединённых в один вычислительный узел, — иначе система начинает выгружать часть данных в куда более медленную оперативную память, и скорость ответов падает на порядок. Именно поэтому конфигурации для локального ИИ строятся вокруг нескольких профессиональных ускорителей одновременно, а не вокруг одного самого быстрого процессора.
Экономика: аренда в облаке против собственного сервера
Аренда мощных GPU-инстансов в облаке — отличный вариант для коротких экспериментов или разовых задач: заплатили за часы использования, получили результат, отключили инстанс. Проблема начинается там, где нагрузка становится постоянной — например, внутренний корпоративный чат-бот, которым сотрудники пользуются весь рабочий день, или система, непрерывно обрабатывающая входящие документы. При круглосуточной эксплуатации почасовая облачная аренда превращается в весьма ощутимую ежемесячную статью расходов, которая никогда не заканчивается, тогда как собственный сервер — это разовая инвестиция, которая продолжает работать без дополнительных счетов. Для нагрузки, работающей постоянно, срок окупаемости собственного оборудования относительно аренды обычно измеряется месяцами интенсивной эксплуатации, а не годами.
Регуляторный аргумент и приватность
Для отраслей со строгими требованиями к конфиденциальности — медицины, юриспруденции, финансового сектора — вопрос часто вообще не в экономике, а в принципиальной возможности использования технологии. Отправка данных клиентов во внешний облачный API может напрямую нарушать условия конфиденциальности, отраслевые нормативы или условия договора с самим клиентом. Локальный инференс модели снимает этот вопрос полностью: данные физически никогда не покидают инфраструктуру компании.
Из чего состоит топовая конфигурация для локального ИИ
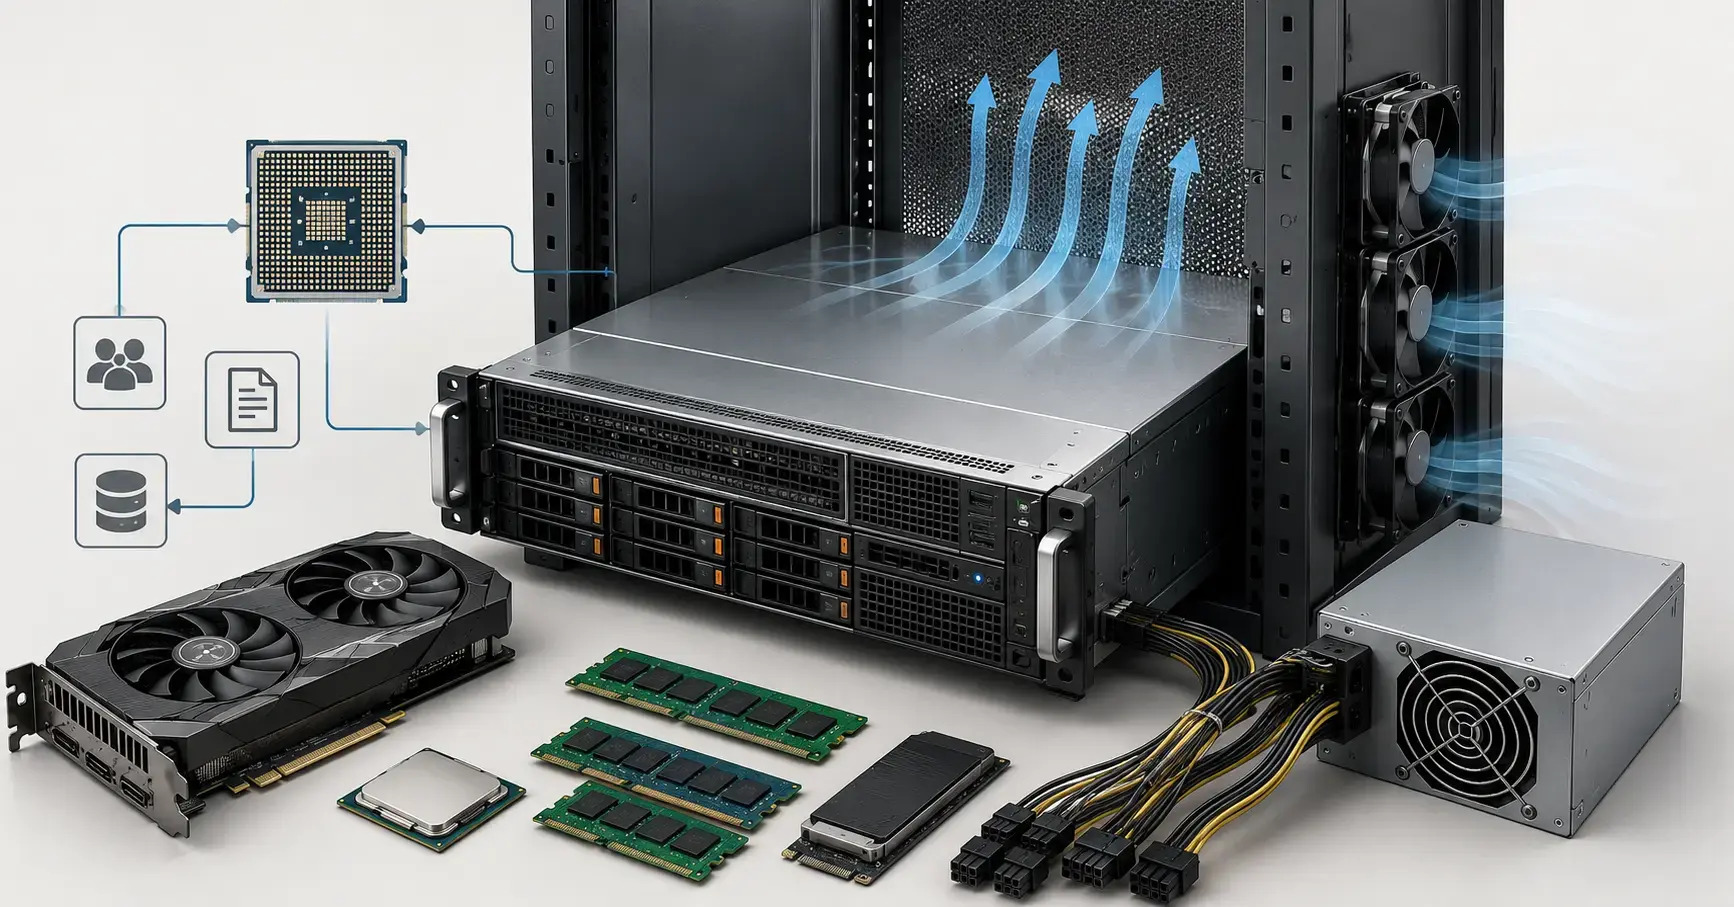
Серьёзная конфигурация для обучения и запуска больших моделей строится на нескольких принципах одновременно: несколько профессиональных видеоускорителей, работающих параллельно, чтобы объединить их видеопамять в единый пул под большие модели; многоядерный процессор рабочей станции (уровня AMD Threadripper PRO) для предобработки данных и оркестрации задач, не создающий узкое место перед GPU; значительный объём оперативной памяти — от 256 ГБ и выше, — чтобы система бесперебойно подавала данные на видеокарты; быстрые NVMe-накопители для хранения датасетов и весов моделей. Для компаний, разворачивающих оборудование в существующей серверной комнате или дата-центре, доступен вариант в стоечном исполнении.
Вывод
Для бизнеса с постоянной, а не эпизодической нагрузкой на ИИ, да ещё и с требованиями к конфиденциальности данных, собственный сервер всё чаще оказывается более рациональным выбором, чем бесконечная аренда чужих GPU-мощностей. Топовые конфигурации для локального обучения и инференса больших языковых моделей, включая варианты для серверной стойки, представлены здесь: https://gamingpc.com.ua/ru/katalog/modelniy-ryad/tensor-9/tensor-9-rack/tip-kompyutera/rabochaya-stantsiya